Digester
Deine gespeicherten Beiträge als private, durchsuchbare Wissensbibliothek.
Endlich lesen, was du gespeichert hast
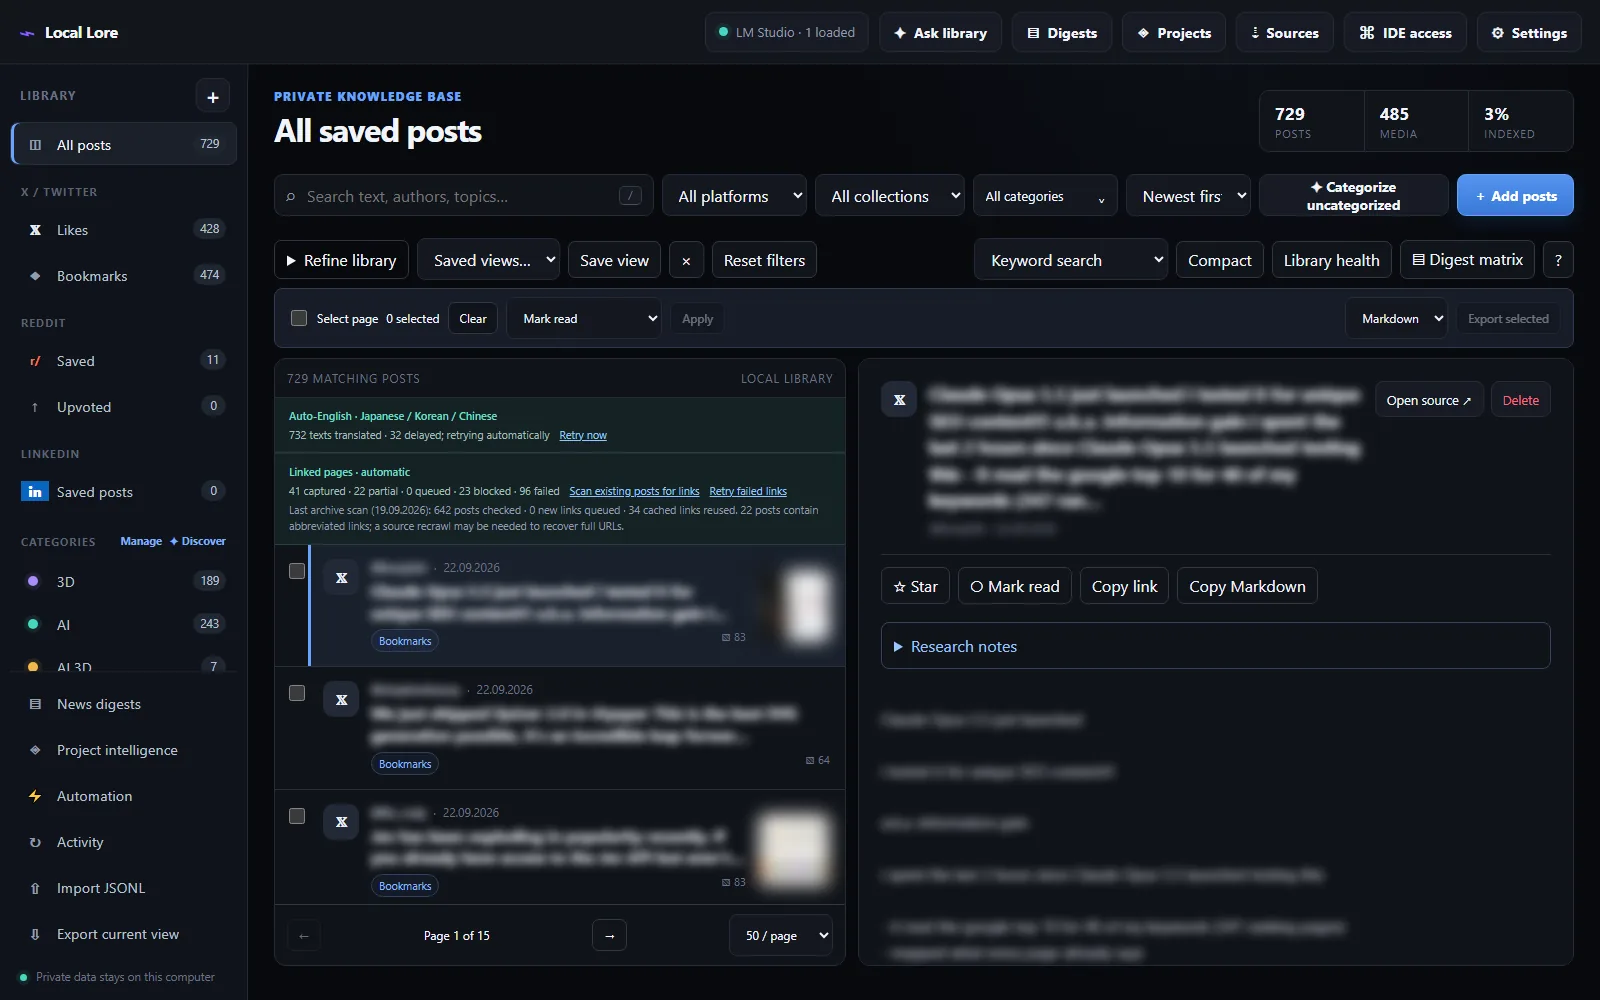
Du speicherst Hunderte Beiträge und liest sie nie wieder. Digester sammelt deine X-Likes und -Lesezeichen, auf Reddit gespeicherte und hochgevotete Beiträge sowie auf LinkedIn gespeicherte Beiträge in einer lokalen Datenbank und macht daraus etwas Brauchbares: Volltext- und semantische Suche, Kategorien, ausführliche Briefings pro Thema und Zeitraum und einen MCP-Server mit Lesezugriff für deinen IDE-Assistenten.
Das Ganze ist bewusst local-first: Der Dienst lauscht nur auf 127.0.0.1, die Bibliothek ist eine einzige SQLite-Datei, Medien liegen auf deiner Festplatte und jede KI-Funktion läuft mit deinen eigenen LM-Studio-Modellen. Keine Entwickler-API-Keys, keine Cloud-Konten, keine Telemetrie.
Funktionen
- Lokal von Grund auf Nur auf 127.0.0.1, eine SQLite-Datei, Medien auf deiner Platte
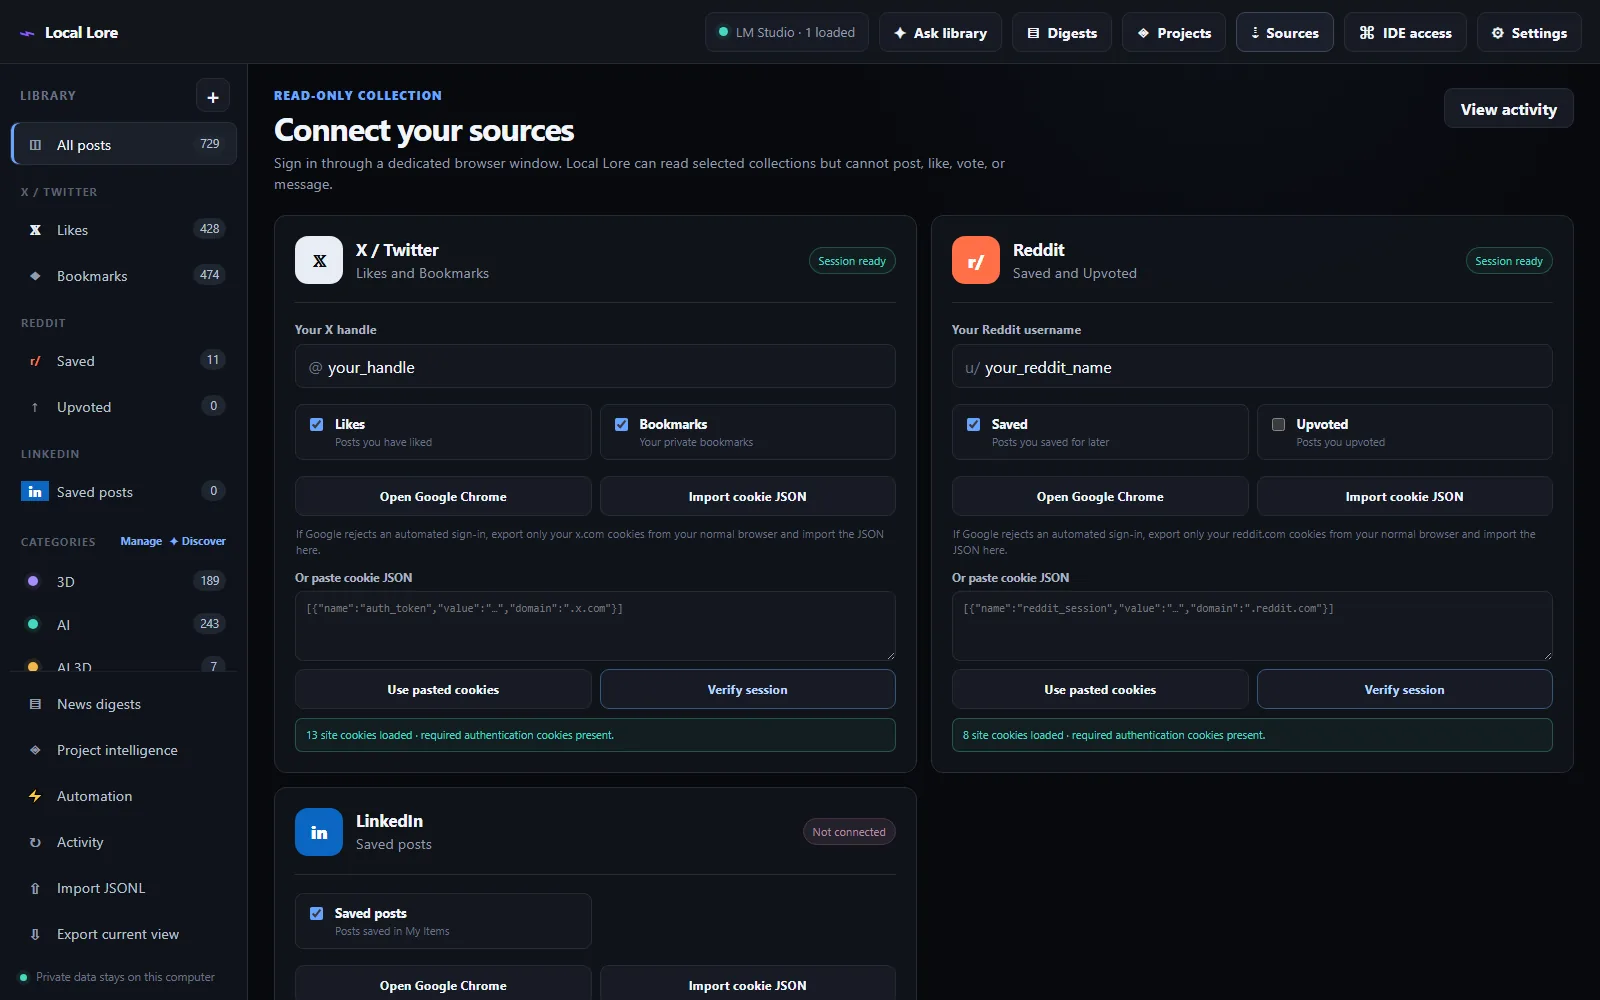
- Keine Entwickler-API-Keys Sammelt über ein eigenes, angemeldetes Browserprofil; dein Passwort wird nie gespeichert
- Sofortige Stichwortsuche Volltextsuche über das ganze Archiv, auch ohne geladenes Modell
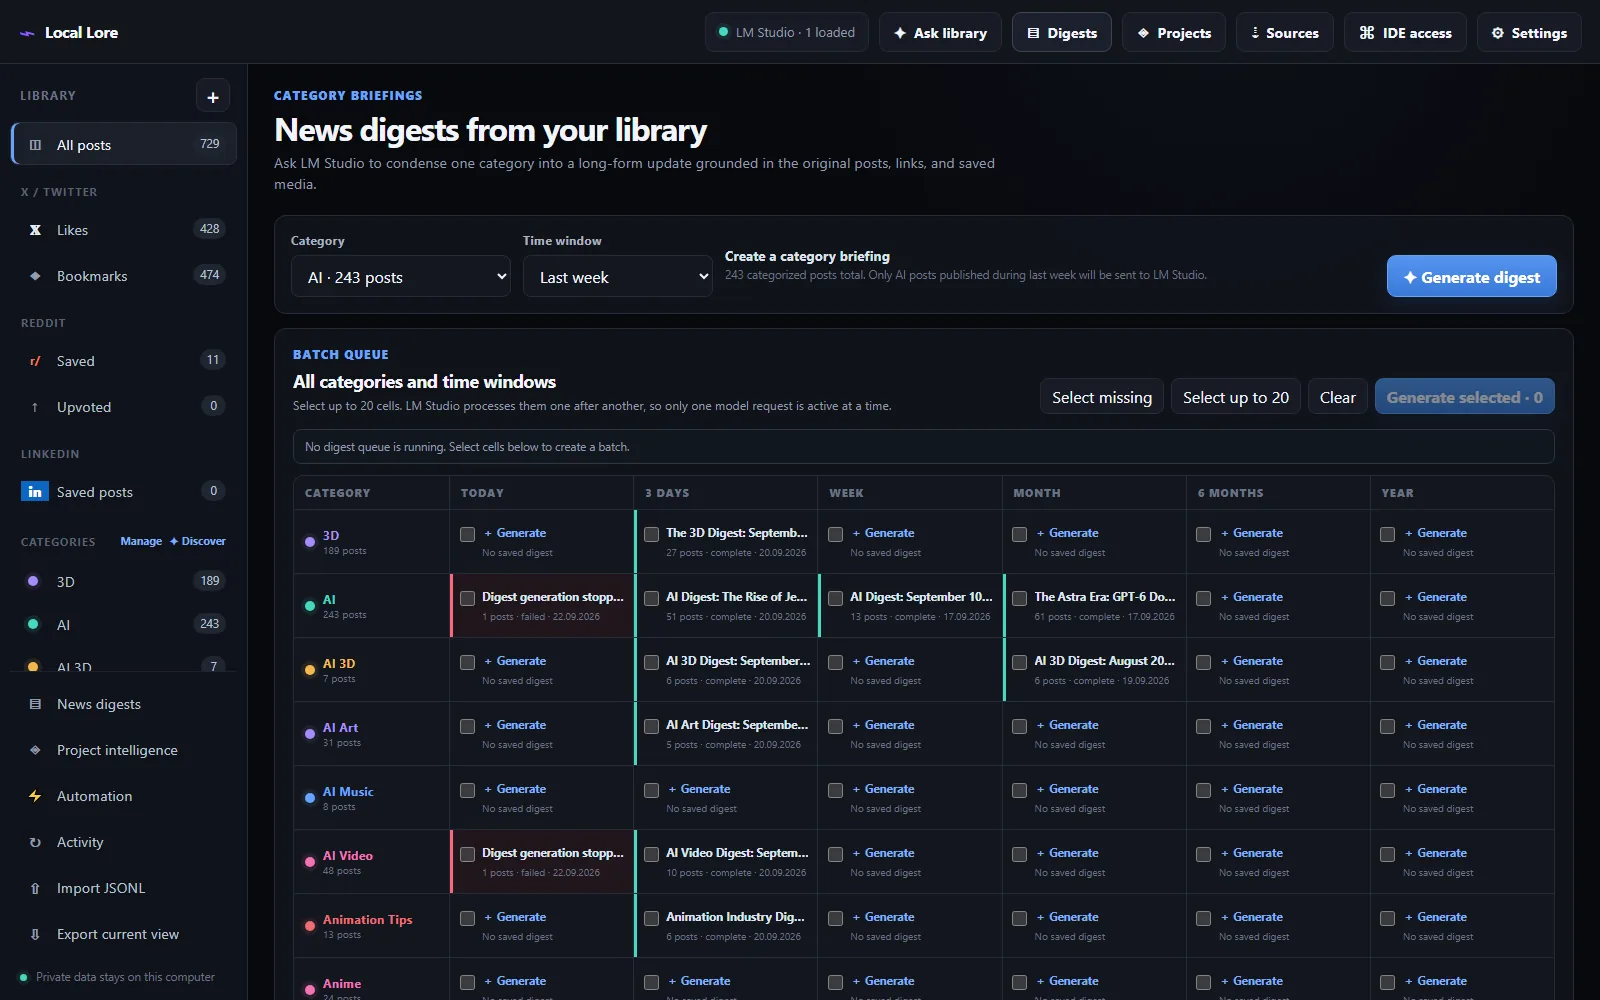
- Kategorie-Digests Briefings für heute, 3 Tage, eine Woche … ein Jahr – mit Quellen, Links und Medien
- Projekt-Intelligenz Gleicht gespeicherte Beiträge mit deinen lokalen Code-Projekten ab – mit Belegen aus deinen Dateien
- GPU-bewusste Automatik Startet Digests nur, wenn die GPUs von LM Studio wirklich frei sind
Der Teil, der verändert, wie du liest
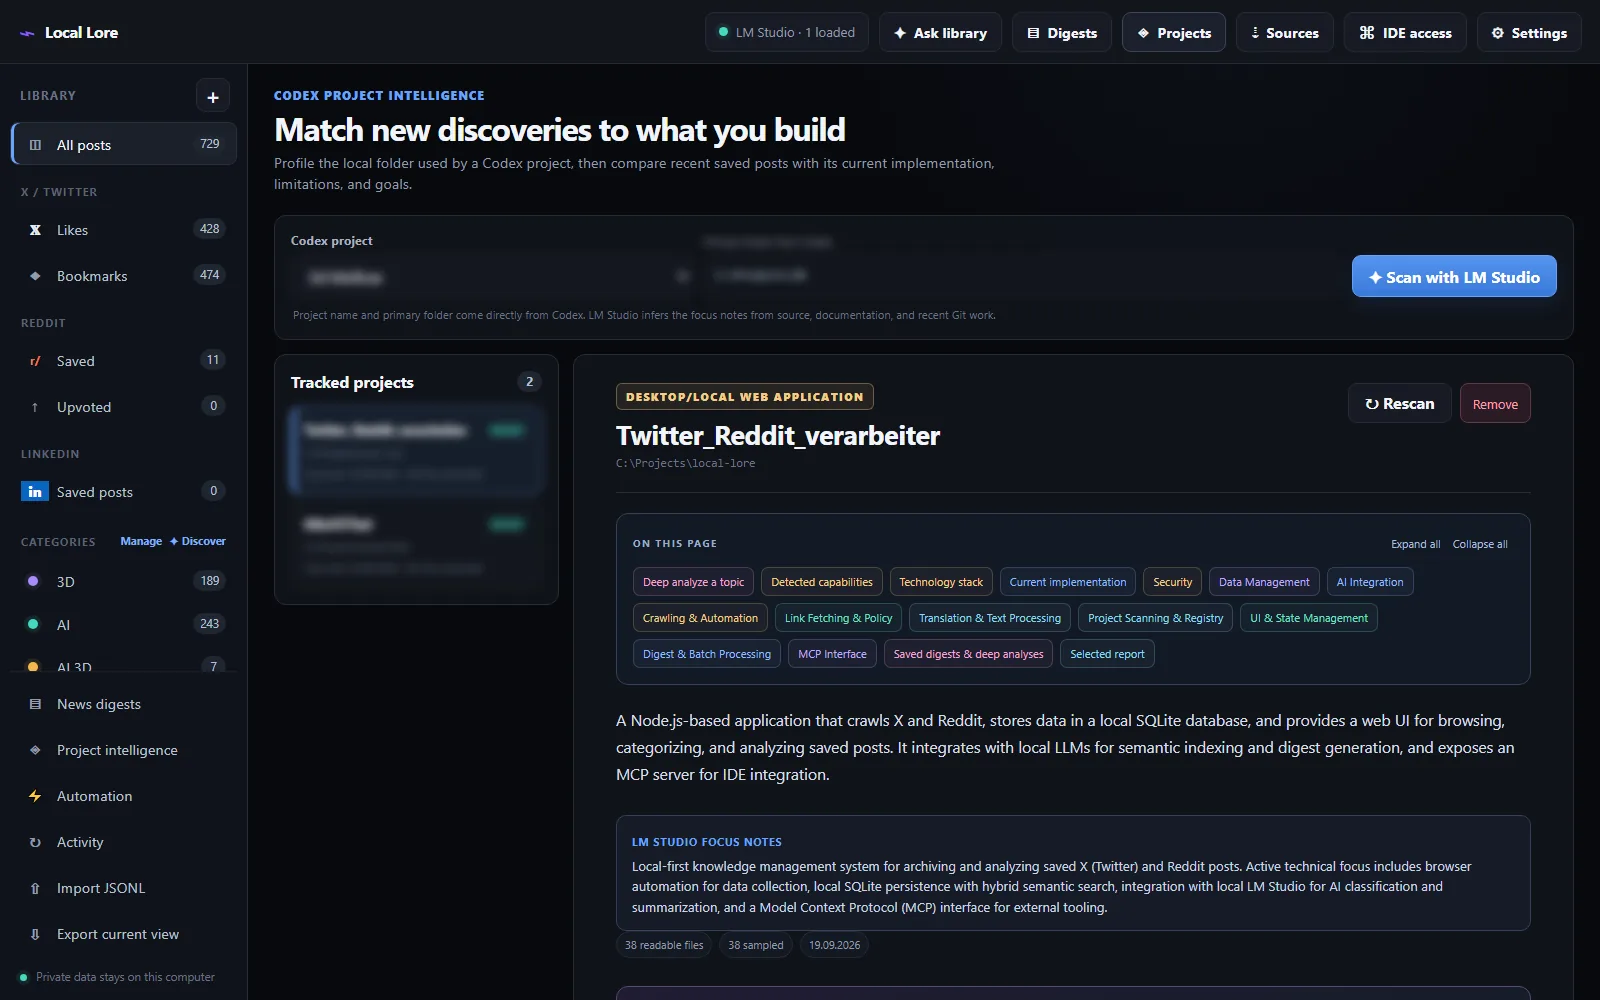
Ein gespeicherter Beitrag ist nur etwas wert, wenn er verändert, was du baust. Richte Digester auf eines deiner lokalen Projekte: Es erstellt zuerst ein Profil davon, was die Codebasis tatsächlich tut, prüft dann deine neuen Beiträge dagegen und behält nur das wirklich Relevante – einen Sicherheitsfix in einer Bibliothek, die du nutzt, eine Technik, die etwas Selbstgebautes ersetzen würde, ein Tool, das zu deinem Stack passt.
Jeder Befund muss sowohl durch einen gespeicherten Beitrag als auch durch Belege aus deinen eigenen Dateien gestützt sein, und der Bericht nennt die betroffenen Projektpfade – mit Vor- und Nachteilen, offenen Fragen und einer priorisierten Liste nächster Schritte.
Screenshots
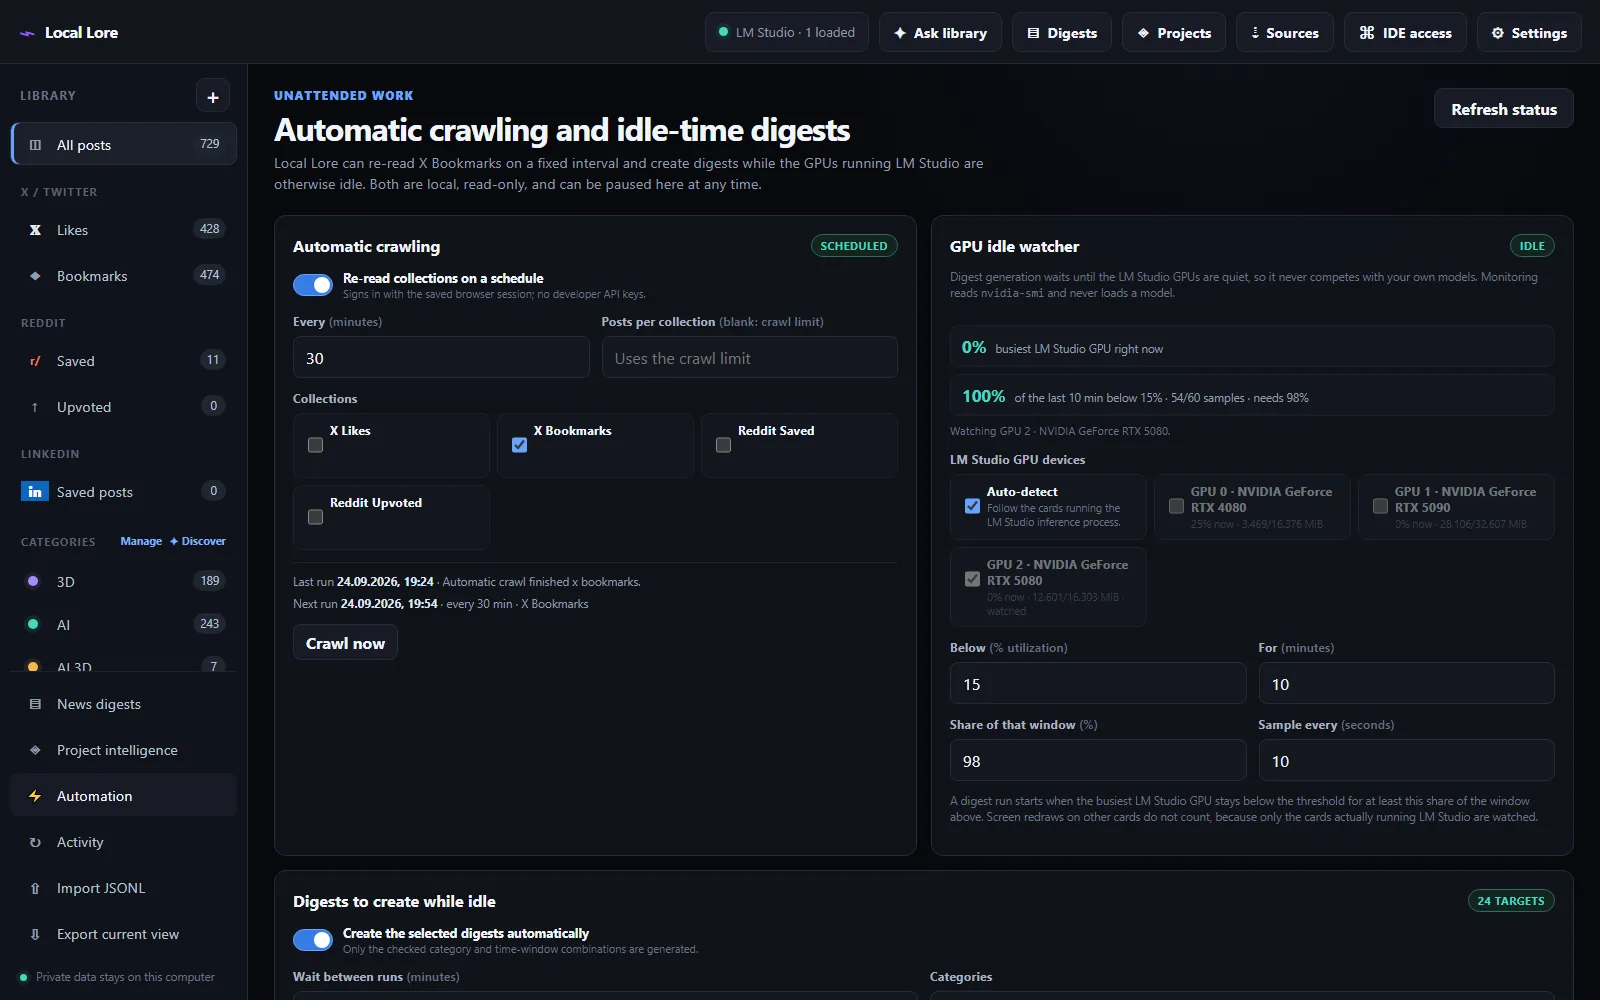
Loslegen
Voraussetzung ist Node.js 20 oder neuer. Sind die Abhängigkeiten installiert, genügt ein Doppelklick auf start-local-lore.bat oder npm start. Der Starter startet den lokalen Dienst im Hintergrund, wartet, bis Port 4317 bereit ist, und öffnet erst dann 127.0.0.1:4317.
- Sources öffnen, X-Handle und Reddit-Benutzernamen eintragen und die gewünschten Sammlungen auswählen.
- Pro Plattform Open Google Chrome wählen und anmelden – oder Cookie-JSON importieren. Danach Verify session.
- Start crawl wählen – oder Run unattended workflow, um in einem Durchgang zu crawlen, zu kategorisieren und die ersten Digests zu erzeugen.
- In Settings LM Studio eintragen (Standard:
127.0.0.1:1234/v1). Ein Chat-Modell und optional ein Embedding-Modell laden. - In der Ask-Ansicht Build semantic index wählen. Die Stichwortsuche funktioniert auch ohne.
- In Library Categorize uncategorized wählen, dann mit Discover Themen finden, an die du nicht gedacht hast.
- Digests öffnen und die ersten Briefings aus der Matrix erzeugen.
- Projects öffnen, ein lokales Projekt auswählen und einen Impact-Digest erzeugen.
Empfohlene lokale Modelle
Digester hat drei Modell-Slots – Chat, Kategorie und Embedding –, weil die Aufgaben sehr unterschiedlich sind. Am besten passt ein mittelgroßes Chat-Modell plus ein kleines Vision-Modell für die Kategorien. Diese Kombinationen wurden mit der App getestet; die VRAM-Angaben gelten für Q4-Quantisierung.
| Setup | Chat-Modell | Kategorie-Modell | VRAM | Abwägung |
|---|---|---|---|---|
| Empfohlen – Bilder & Tempo | Qwen3.5-9B (~5 GB) | Qwen2.5-VL-7B-Instruct (~4 GB, images) | ~9 GB | 3–4× schneller als ein 35B, Kategorisierung mit Bildern, Qualität für diese Aufgaben weiterhin sehr gut. |
| Höchste Qualität | Qwen3.8-27B (~14 GB) | Gemma-4-12B (~6 GB) | ~20 GB | Bessere Digests bei dichtem technischem Inhalt, aber keine Bilder bei der Kategorisierung. |
| Budget – kleinste brauchbare | Qwen3-8B (~4 GB) | Qwen2.5-VL-7B-Instruct (~4 GB) | ~7 GB | Bilder bleiben unter 8 GB möglich. Die Digest-Qualität sinkt bei langen oder technischen Zeiträumen deutlich. |
Für den optionalen Embedding-Slot ein eigenes Embedding-Modell nehmen, nie ein Chat-Modell: nomic-embed-text-v1.5 (~4 GB) oder BAAI/bge-small-en-v1.5 (~2 GB), wenn der VRAM knapp ist. Ohne Embedding-Modell bleibt die Suche einfach stichwortbasiert.
KI- & IDE-Zugriff über MCP
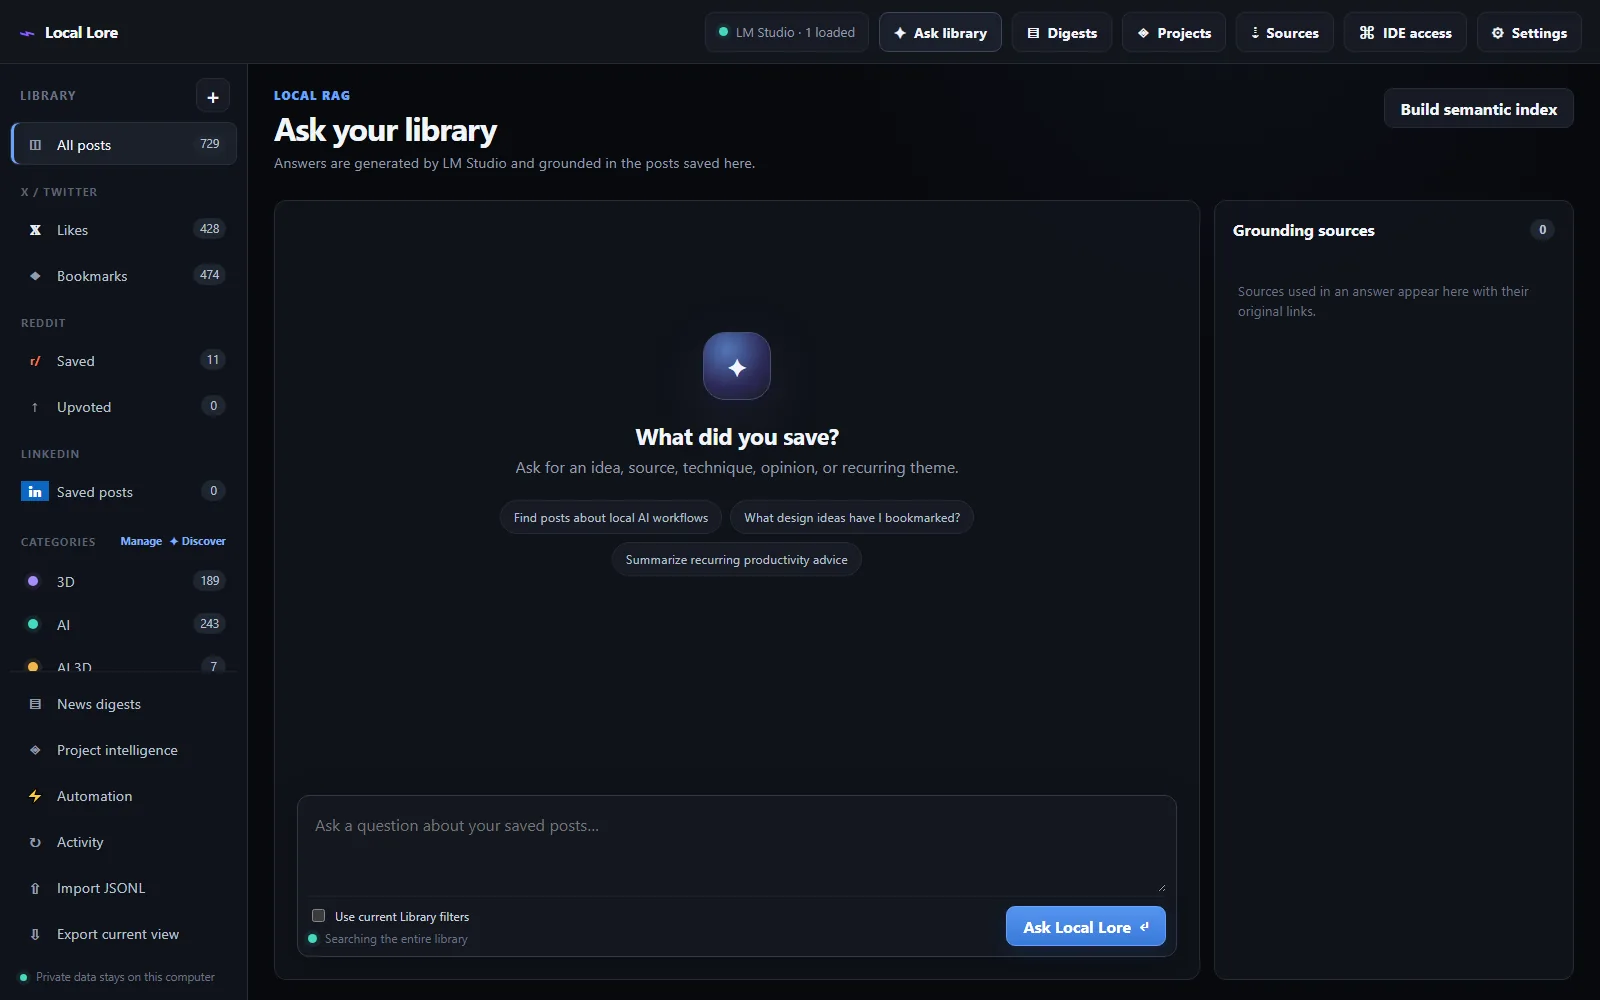
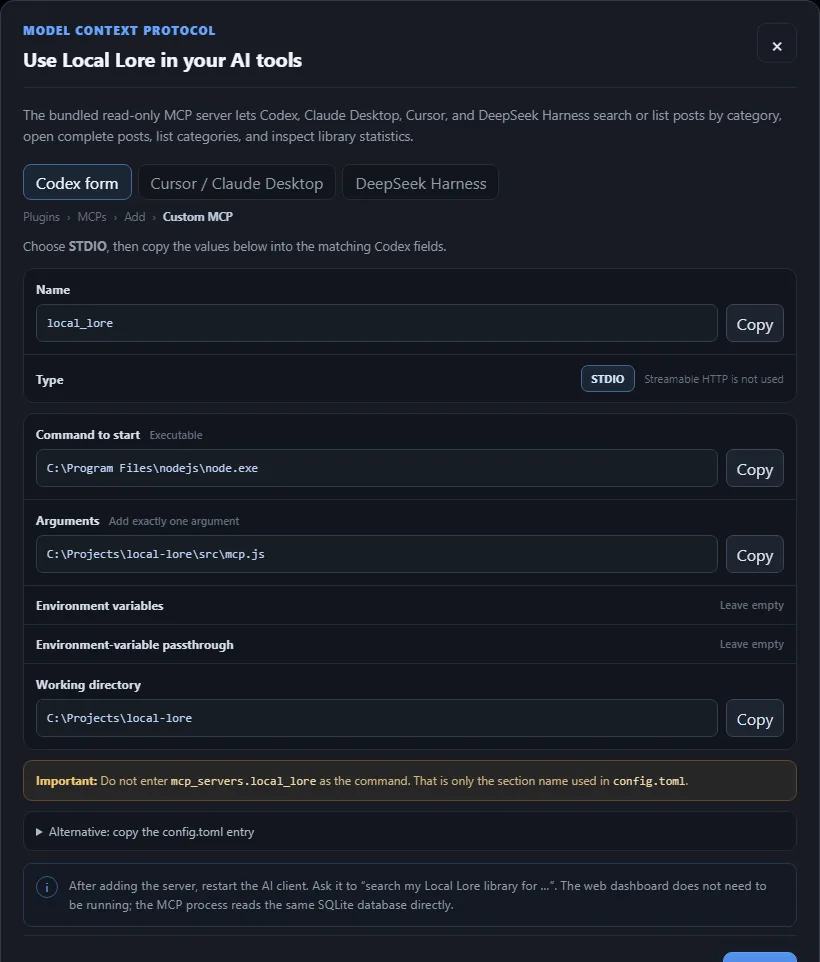
Ein mitgelieferter, rein lesender MCP-Server macht die Bibliothek für Codex, Cursor, Claude Desktop und DeepSeek Harness verfügbar. Das Dashboard muss dafür nicht laufen – der MCP-Prozess öffnet dieselbe SQLite-Datenbank direkt. IDE access im Dashboard zeigt die Konfiguration mit den genauen Pfaden für deinen Rechner.
| Tool | Liefert |
|---|---|
search_social_library | Suche im Archiv, mit den optionalen Bibliotheksfiltern. |
get_social_post | Ein Beitrag samt verlinkter Seiten. |
list_recent_social_posts | Die neuesten Beiträge der Bibliothek. |
list_social_categories | Alle Kategorien mit Beschreibung. |
social_library_stats | Zahlen und Abdeckung des Archivs. |
list_category_digests | Gespeicherte Briefings pro Kategorie und Zeitraum. |
get_category_digest | Ein vollständiges Briefing mit Quellen. |
list_project_profiles | Profilierte lokale Projekte. |
get_project_profile | Ein Implementierungsprofil mit Belegen aus den Dateien. |
list_project_impact_digests | Impact- und Themenberichte zu einem Projekt. |
get_project_impact_digest | Ein vollständiger Impact- oder Themenbericht. |
Sicherheit & praktische Grenzen
- Der Crawler enthält keinen Code zum Posten, Liken, Abstimmen, Folgen oder Schreiben von Nachrichten. Er liest – sonst nichts.
- Der Server lauscht nur auf
127.0.0.1. LM-Studio-Adressen sind auf localhost oder private Netzwerkadressen beschränkt. - Medien werden nur von bekannten Medien-Hosts von X, Reddit und LinkedIn geladen, höchstens 25 MB pro Datei.
- Soziale Netzwerke ändern ab und zu ihr HTML. Liefert ein Crawl plötzlich keine Beiträge mehr, brauchen die Selektoren eventuell ein kleines Update.
- Zurückhaltende Crawl-Limits verwenden und die Nutzungsbedingungen und Rate-Limits der Plattformen beachten.
- Die Anmeldung liegt in einem lokalen Browser-Profil. Exportierte Cookies wie ein Passwort behandeln – nie weitergeben oder committen.